PC 데스크톱 애플리케이션의 메모리 최적화와 멀티스레딩 아키텍처
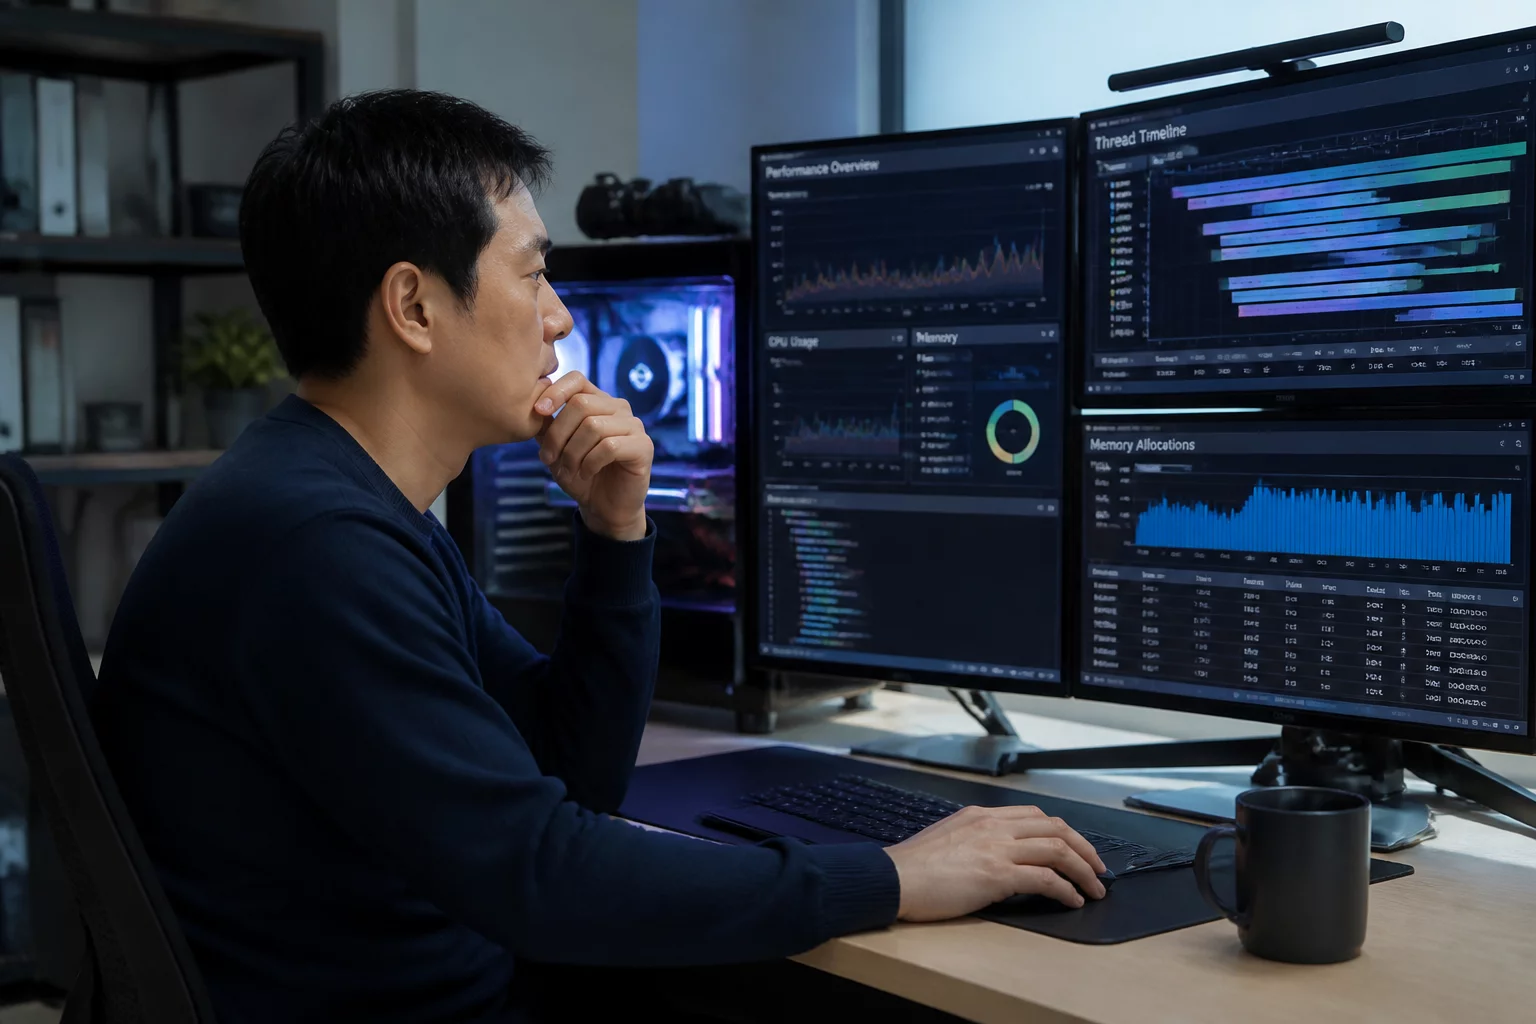
현대 PC 데스크톱 환경은 수십 기가바이트 단위의 고용량 램과 수많은 코어를 기본으로 탑재하고 있습니다. 하지만 하드웨어 제원이 넉넉해졌다고 해서 소프트웨어가 저절로 빨라지지는 않습니다. 불필요한 객체 할당과 비효율적인 동기화 구조는 최신 하드웨어 위에서도 여전히 화면 멈춤과 응답 지연을 초래하는 주범입니다.
안정적인 성능을 장시간 유지하려면 하드웨어 자원을 다루는 근본적인 접근 방식을 점검해야 합니다. 특히 시스템 메모리의 파편화를 줄이고 코어 간 경합을 배제하는 설계 패턴이야말로 데스크톱 프로그램의 수명을 결정짓는 핵심 기술입니다.
메모리 파편화 방지와 객체 수명 제어
운영체제에 메모리 공간을 지속적으로 요청하고 반환하는 과정은 심각한 오버헤드를 유발합니다. 특히 단시간에 생겼다 사라지는 소형 객체가 힙 메모리 전역에 흩어지면 연속된 공간이 부족해지는 메모리 파편화 현상이 가속화됩니다. 가비지 컬렉션이나 힙 정리 루틴이 동작하는 순간 사용자 인터페이스는 급격한 프레임 드랍을 겪습니다.
이를 완화하기 위해 사전에 일정 크기의 블록을 할당해두는 객체 풀링 기법을 도입해야 합니다. 재사용 가능한 데이터 구조를 큐나 스택 형태로 관리하며 필요할 때 꺼내 쓰고 제자리에 돌려놓는 순환 구조를 구축하십시오. 할당 요청 횟수 자체가 줄어들면서 운영체제 커널의 개입 빈도가 눈에 띄게 감소합니다.
UI 반응성을 지키는 동시성 파이프라인
사용자와 직접 맞닿는 메인 스레드는 오직 화면 렌더링과 이벤트 처리에만 전념해야 합니다. 파일 입출력이나 고밀도 수학 연산 같은 무거운 처리를 백그라운드로 안전하게 격리하는 파이프라인이 필수적입니다. 스레드를 단순히 생성하고 종료하는 방식 대신 작업 단위로 분할하여 실행하는 스레드 풀을 상시 가동하십시오.
안정적인 파이프라인 설계를 위해 지켜야 할 주요 구현 원칙들은 다음과 같습니다.
- 작업 큐 크기를 제한하여 백프레셔를 유도하고 메모리 고갈 사태를 방지합니다.
- 락 프리 기반 단일 생산자 다중 소비자 구조로 동기화 대기 시간을 최소화합니다.
- 스레드별 로컬 버퍼를 독립적으로 운영하여 캐시 라인 무효화를 억제합니다.
- 원자적 연산을 우선 적용하여 상호 배제 잠금에 따른 문맥 교환 비용을 줄입니다.
- 작업 완료 신호를 메인 루프 이벤트 큐에 메시지 형태로 안전하게 전달합니다.
스레드 간의 데이터 교환이 빈번할수록 잠금 장치의 존재는 병목이 됩니다. 뮤텍스 대신 원자적 연산과 무잠금 자료구조를 적극적으로 배치하여 스레드가 다른 코어의 작업 완료를 기다리며 멈춰 서는 시간을 제거하십시오.
캐시 지역성을 고려한 데이터 구조 재배치
현대 중앙처리장치의 연산 속도는 주 메모리의 읽기 쓰기 속도보다 훨씬 빠릅니다. 객체 지향 설계를 맹목적으로 따르다 보면 포인터를 타고 메모리 여기저기를 탐색하는 구조가 만들어져 캐시 미스가 폭증합니다. 데이터가 서로 인접한 공간에 정렬되어 있지 않다면 멀티코어 환경의 연산 잠재력을 절반도 끌어내지 못합니다.
관련된 데이터 필드만을 모아 연속된 배열 형태로 저장하는 데이터 지향 설계를 부분적으로 결합하십시오. 연속 메모리 순회는 하드웨어 프리페처의 효율을 극대화하여 연산 처리량을 비약적으로 향상시킵니다. 구조체의 정렬 단위를 CPU 캐시 라인 크기인 64바이트에 맞추는 세심한 배치만으로도 유의미한 성능 차이가 발생합니다.
멀티코어 확장성을 위한 진단과 지속적 튜닝
스레드 개수를 무작정 늘린다고 해서 연산 속도가 선형적으로 증가하지는 않습니다. 특정 코어가 작업을 끝내지 못해 나머지 코어가 공회전하는 불균형 상태를 감시해야 합니다. 작업 단위를 균등하게 쪼개어 유휴 스레드가 남은 작업을 가져가는 워크 스틸링 알고리즘을 도입하면 코어 가동률을 고르게 유지할 수 있습니다.
주기적으로 프로파일러를 구동하여 락 경합 지점과 비정상적인 메모리 증가 패턴을 계측하는 습관이 코드 작성만큼이나 중요합니다. 세부적인 하드웨어 특성을 이해하고 이에 맞춘 메모리 관리와 스레드 격리를 실천할 때 데스크톱 프로그램은 비로소 타협 없는 성능을 증명합니다.
엔지니어링 측정 지표
우리에 관해서
코멘트
우리의 파트너